ИИ-агенты в git worktree: как развести параллельных и не потерять код
Каждому параллельному ИИ-агенту нужен свой git worktree - отдельная рабочая папка со своей веткой, иначе агенты перепишут файлы друг друга. Но worktree спасает только от затирания на диске: сначала поделите файлы между агентами так, чтобы у двух задач не было общих, а задачи с общими файлами ставьте в очередь.
ИИ-агенты в git worktree: зачем каждому параллельному агенту своя папка, почему без владения файлами это не спасает и как работает связка исполнитель + критик.
В статье · 8 разделовразвернутьсвернуть
Два ИИ-агента в одной папке проекта рано или поздно перепишут файлы друг друга. Лекарство известное: каждому агенту свой git worktree, то есть отдельная рабочая папка со своей веткой, плюс заранее поделённые между агентами файлы. Без второго первое не спасает. Ниже - как это сделал автор браузерной танковой игры на Three.js, как это устроено в Claude Code в ноябре 2026 и как я сам параллелю (точнее, чаще не параллелю) агентов на ИИ-мастере DnD.
Что такое git worktree и зачем он ИИ-агентам
Git worktree - это дополнительная рабочая папка того же репозитория, у которой своя выгруженная ветка и свой индекс, а история и объекты общие. Для ИИ-агентов это способ дать каждому параллельному агенту отдельный диск: он правит, запускает тесты и коммитит у себя, не трогая файлы соседа и не залезая в его незакоммиченные изменения.
Под капотом это обычная команда git, которой сто лет в обед: git worktree add <путь> <ветка> создаёт папку, git worktree list показывает все, git worktree remove убирает. Главная защита встроена прямо в git: по умолчанию add откажется создавать worktree, если эта ветка уже выгружена в другом worktree (документация git-worktree, git 2.56). То есть два агента физически не могут сидеть на одной ветке.
Зачем это агентам, а не людям? Человек открывает одну задачу за раз. Агентов мы запускаем пачкой, и каждый из них уверен, что он в репозитории один. Две сессии в одной папке - это гонка: один агент правит файл, второй тут же перезаписывает его своей версией, третий запускает тесты на смеси обоих изменений и честно рапортует "всё зелёное". Хаос, в котором потом никто не разберётся, включая тебя.
Как развести ИИ-агентов по worktree: кейс Claude of Tanks
Пример, на котором удобно всё показать, - Claude of Tanks, браузерная мультиплеерная игра про танки на Three.js (пост в канале "Нейроцех", 2026, сама игра). Автор в детстве гонял в World of Tanks Blitz и решил собрать свою версию. Внутри больше сотни танков, разные типы снарядов, броня по зонам, повреждения экипажа и модулей, подвеска, разрушаемые объекты и отлетающие башни.
Собирал он всё через Claude Code и Codex как маленькую команду. И вот что из этого интересно:
- Правила проекта лежат в репозитории, а не в чатах. В AGENTS.md - постоянные инварианты: единицы измерения, фиксированные 60 Гц симуляции, требования к детерминированности, проверки для новых машин. Отдельные файлы инструкций - на симуляцию, танки, сеть, интерфейс, звук, эффекты и генерацию мира.
- Ответственность у агента узкая. Парк танков разбит на семейства, один агент получает конкретную машину или группу машин и правит только свои файлы.
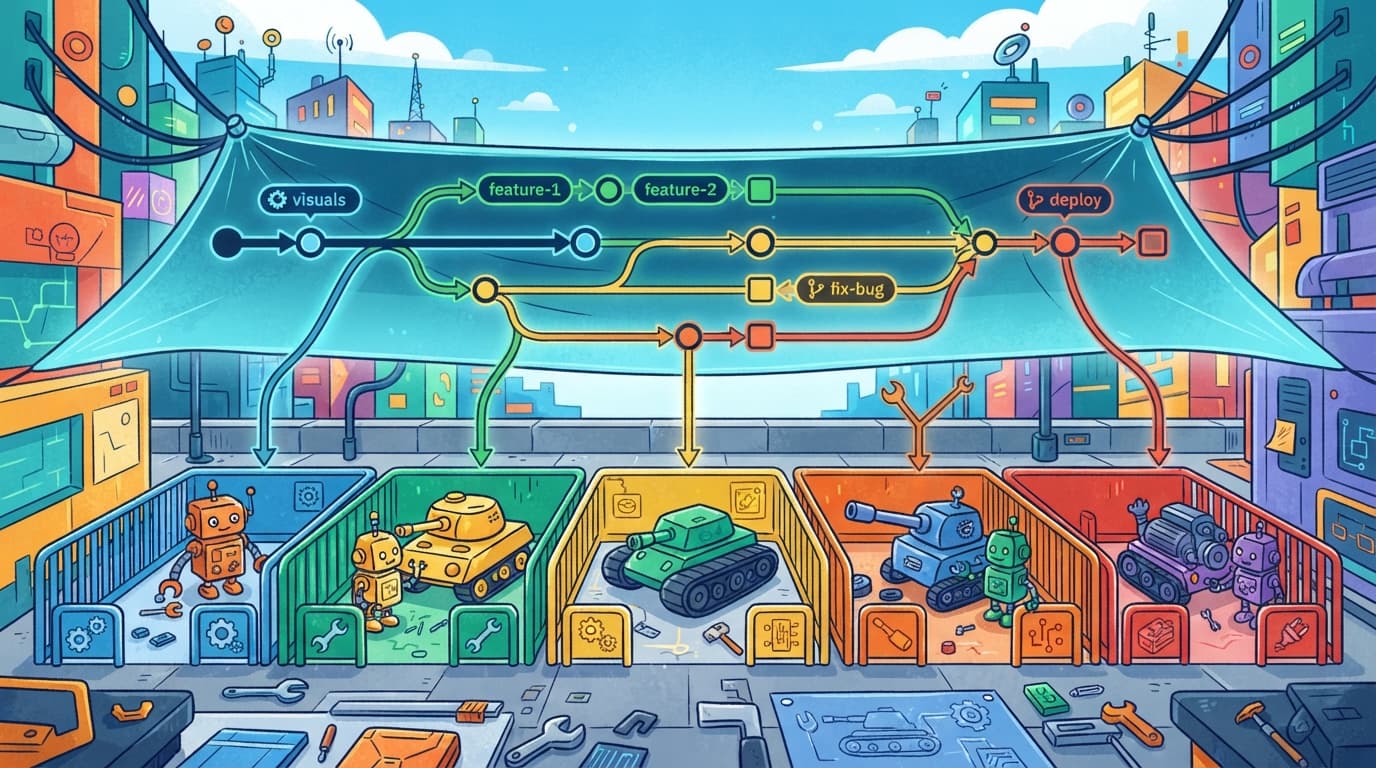
- Параллельные агенты разведены по отдельным git worktree и файлам. Иначе две сессии могли одновременно переписать одно и то же или сгенерировать ассеты поверх грязного рабочего дерева.
- Готовый движок не брали: Three.js только рисует, а движение, броню, урон, ботов и сеть агенты писали сами.
Обрати внимание на порядок. Сначала поделили зоны владения (семейства танков, системы игры), и только потом раздали агентам по worktree. Worktree тут не стратегия, а забор вокруг уже нарезанного участка.
Почему одного worktree мало: делите файлы по владельцам
Worktree защищает от затирания на диске, но не от конфликта по смыслу. Если два агента в двух worktree правят один и тот же файл, они спокойно доработают каждый у себя, а встретятся уже на мерже. Конфликт никуда не делся, его просто отложили до момента, когда исправлять дороже всего.
Хороший пример из первых рук - эксперимент Anthropic, где 16 параллельных Claude примерно за 2000 сессий писали компилятор C (Anthropic Engineering, 05.02.2026). Пока было много независимых падающих тестов, параллельность работала отлично. Как только дошли до сборки ядра Linux, все агенты упёрлись в один и тот же баг и затирали исправления друг друга. Помогло не добавить агентов, а найти способ порезать задачу на независимые куски.
Документация Claude Code говорит то же самое другими словами: участники agent teams worktree-ами не изолируются, поэтому файлы между ними надо делить по владельцам, иначе два участника в одном файле - это перезапись (Claude Code docs, agent teams).
Отсюда правило, которое я вывел для себя: сначала карта "файл - хозяин", потом worktree. Если не получается нарисовать карту так, чтобы у двух задач не было общих файлов, - параллелить нечего, сколько папок ни создай.
Как работает связка агент-исполнитель и агент-критик
Связка "исполнитель + критик" - это когда один агент делает изменение, а второй, отдельный, проверяет результат по жёстким критериям и может завернуть работу. Критик не пишет код и не чинит, он только ищет, что сломано. Так агент не принимает сам у себя.
В Claude of Tanks цикл выглядел так: агент-исполнитель правит свою машину, прогоняет проверки и делает скриншоты. Потом агент-критик смотрит на рендер и ищет кривые пропорции, пересечения деталей, дыры в поверхностях, проблемы с гусеницами и узнаваемостью модели. И только после этого главный агент ещё раз гоняет проверки и принимает изменения. Визуал доводили циклом "изменил - отрендерил - посмотрел - измерил - снова прогнал проверки". Тем же конвейером сделали трейлер: агенты расставляли танки, строили пролёты камеры, писали бой в браузере и пересматривали кадры.
Почему это работает, Anthropic объясняет в разборе упряжи для длинной разработки: агенты уверенно хвалят собственную работу, даже посредственную, а настроить отдельного скептичного оценщика сильно проще, чем научить генератор критиковать себя (Anthropic Engineering, 24.03.2026). Автор танков пришёл к тому же: Claude стал заметно надёжнее, когда у каждой системы появились инварианты и условия, при которых проверка обязана упасть. Но для графики этого не хватило, понадобились глаза критика.
Важная деталь для worktree: критику не нужен свой. Он read-only, смотрит на скриншоты и результаты проверок исполнителя. Отдельная папка нужна только тем, кто пишет. Про то, как делать скриншот-диффы для игры, я подробно писал в статье про сид, команды и скриншоты для Claude Code.
Как я параллелю ИИ-агентов на ИИ-мастере DnD
Теперь честно про свой проект - Telegram-бот с ИИ-мастером DnD, где агенты пишут код хода, денег, квестов. Короткий ответ: почти не параллелю, и это осознанное решение, а не лень :)
В конвейере разработки (лид-оркестратор, дев-агент, QA-агент) с конца июля 2026 действует жёсткий инвариант: один общий checkout равен одному деву. Деву прямо запрещено делать push, merge и worktree. В разборе конвейера от 28.07 записано: второй дев параллельно - только с изоляцией worktree и по моему явному разрешению, и пока не нужен, потому что дев не был узким горлом. Держится это не из-за git, а потому что два дева почти гарантированно окажутся в одном файле.
В конце октября я снова к этому вернулся и посчитал, можно ли пустить двух девов в двух worktree, а лид проверял бы ворота в третьем. Цифры по плану эпика вышли такие:
| Что посчитал | Значение |
|---|---|
| Задач в плане эпика | 149 |
| Из них трогают общий modules.yaml | 100 |
| Трогают flags.py | 30 |
| Пар задач без общих файлов в фазе D2 | 72 |
| Пар без общих файлов в фазе F2 | 28 |
| Оценка ускорения "по файлам" | ×1,5-1,8 |
| Оценка скептика "на выходе к пользователю" | ×1,1-1,3 |
Замер по plan.json эпика, 28.10.2026.
Скептик-агент (та самая связка исполнитель + критик, только на планировании) разнёс оптимистичную оценку. Пары посчитаны по плану, а реальные правки девов часто выходят за список файлов. Деплой, QA и включение флагов всё равно идут в одну очередь. А лид и так тратил треть бюджета: по замеру 27.10 у него около 520M кэш-чтений, второй дев добавил бы ещё 20-50M на задачу. Итоговое правило: параллелить девов есть смысл, только если на написание кода уходит больше ~40% срока задачи. И пилотировать на 2-3 парах из разных флагов, а не переписывать процесс разом.
Один прецедент при этом был: задача AU-35 шла в worktree параллельно с AU-17 (PR #182 и #183) и прошла нормально. Но AU-35 правил инструменты и документы, код хода не трогал - то есть ровно тот случай, где карта владения тривиальна.
И деталь, которую без практики не придумаешь. Один из моих тестов страж-хука коммитов, запущенный из linked worktree, писал в индекс основного репо, а не своей папки. Виноваты унаследованные переменные окружения GIT_*, которые тест получал от родительского процесса. Лечится тем, что тест чистит GIT_* перед запуском. Тест на изоляцию сам оказался неизолированным, смешно) Worktree изолирует файлы, но не окружение процесса.
На сайте история попроще: дев-агенту в промпт пришлось дописать, как ставить зависимости в worktree под pnpm 11, а саму папку worktree и рабочие файлы агентов я добавил в .gitignore отдельным коммитом. Мелочь, но без неё первый же агент в свежей папке валится на пустом node_modules.
Как настроить git worktree для Claude Code: пошагово
Порядок для Claude Code в редакции ноября 2026 (документация worktrees, версии 2.1.x) и чистого git. Сквозной пример - те же два агента: один пилит мини-апп, второй - тесты бота.
- Нарисуй карту владения. Для каждой задачи - список файлов, которые она трогает. У параллельных задач пересечений быть не должно, иначе - в очередь.
- Добавь в
.gitignoreпапку.claude/worktrees/, чтобы worktree не светились как неотслеживаемые файлы в основном checkout. - Если агенту нужны игнорируемые файлы вроде
.env, создай в корне.worktreeincludeв синтаксисе.gitignore. Копируются только файлы, которые и совпали с шаблоном, и игнорируются git. - Запусти каждого агента в своём worktree. В Claude Code это флаг
--worktree(или-w) с именем: worktree появится в.claude/worktrees/<имя>/на веткеworktree-<имя>. - Для субагентов пропиши
isolation: worktreeво frontmatter агента в.claude/agents/. Без изменений такой worktree удалится сам, когда субагент закончит. - Поставь зависимости в каждом worktree. Это свежий checkout: venv, node_modules и прочее там пустые.
- Мержи по одному. Перед PR дев подтягивает основную ветку внутри своего worktree и сам решает конфликт, потом остальные подтягивают свежий main.
- Прибери за собой. Запуски через
claude -pworktree не чистят, это делается руками черезgit worktree removeиgit worktree prune.
Минимальный набор команд выглядит так:
# в основном checkout
echo ".claude/worktrees/" >> .gitignore
printf ".env\n.env.local\n" > .worktreeinclude

# два агента, две папки
claude --worktree mini-app
claude --worktree bot-tests

# ручной вариант без Claude Code
git worktree add ../app-tests -b agent/tests
git worktree list
git worktree remove ../app-tests
git worktree prune
По умолчанию Claude Code ответвляет worktree от ветки по умолчанию на remote, обычно main. Если агент должен стартовать от твоей текущей работы, в настройках ставится worktree.baseRef со значением "head". Имя конкретной ветки туда указать нельзя: для этого worktree создаётся обычным git, а агент запускается уже в нём (Claude Code docs, worktrees).
Как ставить самим агентам задачи с границами по файлам, я разбирал в статье про бриф для ИИ-агентов. А кого из моделей сажать исполнителем, а кого оркестратором, - в тексте про дорогого оркестратора и дешёвых исполнителей.
Когда параллельные ИИ-агенты в worktree не нужны
Не нужны, если узкое горло не в написании кода. У меня в DnD-боте время задачи съедают QA на проде, ожидание деплоя и ворота флагов. Второй дев просто быстрее доедет до той же очереди. Если код - меньше ~40% срока задачи, не заморачивайся: worktree добавят токенов, мерж-конфликтов и папок, которые забудешь удалить.
Ещё случаи, где я бы не стал:
- Хот-файлы. Если почти каждая задача трогает один и тот же файл (у меня modules.yaml в 100 из 149), параллельность мнимая, конфликт просто переедет на мерж.
- Одна монолитная проблема. Как в истории с ядром Linux у Anthropic: десять агентов на один баг не чинят его в десять раз быстрее.
- Смысловая связь без общих файлов. Три моих задачи про отношение NPC не делили ни одного файла, но меняли одно поле под одним флагом. Порядок там задаёт, кто хозяин поля, и разводить их по worktree нельзя.
- Ты сам. Каждый параллельный агент - это ещё один поток, который надо принять. Как принимать работу у агента и почему это теперь главный навык, я писал в статье про мясной мешок в агентском пайплайне.
Короче, worktree - забор, а не план. Сначала режешь работу на участки с одним хозяином, потом ставишь заборы. Наоборот не работает.
Частые вопросы
Сколько ИИ-агентов можно запускать параллельно?
Столько, сколько у вас задач без общих файлов и сколько вы успеваете принимать. На практике это 2-3 агента: каждый добавляет токены, мерж и поток, который надо проверить. Если узкое горло - QA или деплой, а не написание кода, лишние агенты ничего не ускорят.
Чем git worktree отличается от git clone для агентов?
Worktree делит с основным репозиторием историю и объекты, поэтому создаётся быстро и не занимает место под второй .git. Git не даст выгрузить одну ветку в два worktree. Клон полностью независим, но его коммиты надо гонять через push и fetch.
Защищает ли worktree от опасных команд агента?
Нет. Worktree изолирует рабочие файлы и ветку, но не файловую систему и не окружение процесса: агент может выйти за пределы папки, а унаследованные переменные GIT_* могут увести git в основной репозиторий. Для безопасности нужны песочница и права, а не worktree.
Как готовился материал: черновик собран моим AI-конвейером по темам и заметкам из практики, факты сверены с первоисточниками, финальный текст я прочитал, поправил и утвердил перед публикацией. Обложку к статье тоже рисует нейросеть. Про сам конвейер — в разделе обо мне.